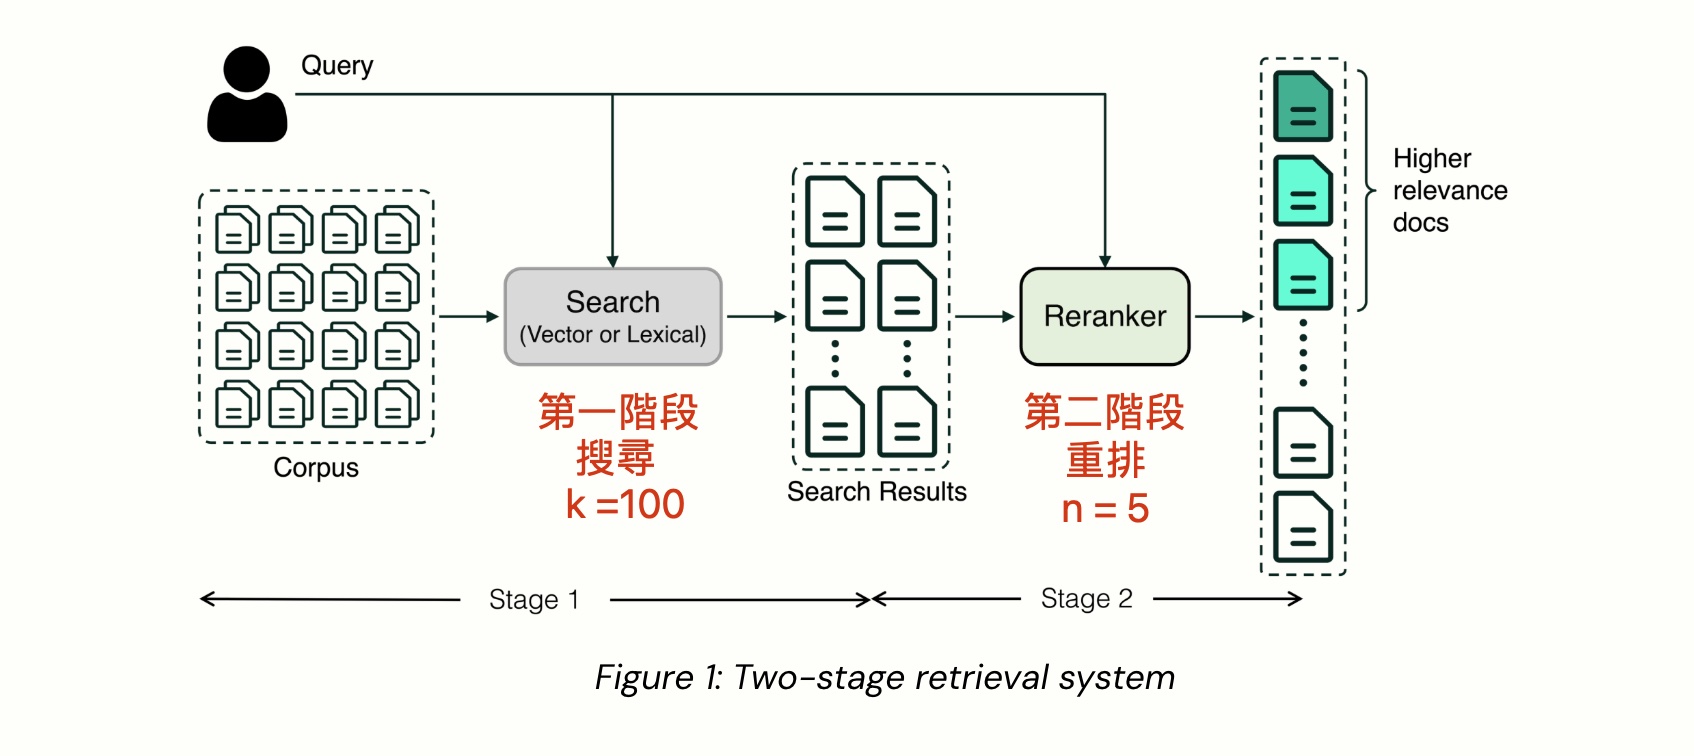
兩階段檢索:全部 5,081 題先用 OpenAI text-embedding-3-small,從 DRCD 與 TWSE-news-v1 合併的 1,651 份文件選取 Top 100,再由 reranker 重排取前 5,計算全部資料的 Hit Rate@5 與 MRR@5。
第一階段的 Hit Rate@100 為 97.2840%(約 0.9728)。正確段落若未進入 Top 100,後續 reranker 就無法找回;因此,即使重排完全正確,Hit Rate@5 與 MRR@5 的理論上限也只能達到第一階段的 Hit Rate@100。下方兩張圖的 Y 軸最大值據此設為 0.9728。
開放權重模型 MRR@5 與 Latency
閉源商用模型 MRR@5 與平均每題價格($ / 題)
Cross-Encoder 技術類型
本表的 Cross-Encoder 指將問題與單份候選文件放在同一個模型輸入中,透過 token 間互動計算相關性,再合併各文件分數排序。表格統一顯示 Cross-Encoder,以下補充各模型的架構與評分方式。模型底座、注意力形式與評分頭是不同面向,這些說明不是互斥的通用分類標準。
Encoder-only: BGE v2-m3 與 Jina v2 使用 XLM-RoBERTa,MiniLM 使用 BERT 類架構,GTE multilingual 使用 encoder-only Transformer。這些模型皆以雙向編碼器處理問題/文件配對,再由序列分類頭輸出相關性分數。
Jina v2 使用官方滑動視窗方法:每個問題/文件視窗合計最多 1,024 tokens,問題最多 512 tokens;長文件以重疊 80 tokens 的視窗處理(最多文件視窗容量的四分之一),文件分數取所有視窗的最高 sigmoid 分數。每題完整重排全部 100 份候選,BF16、batch size 8,使用官方 PyTorch 原生注意力。Latency 包含全文 tokenization、所有視窗推論、分數合併及 Top5 排序。
LLM Token Scoring: Qwen3 Reranker 的 0.6B 、4B 與 Mixedbread v2 使用經排序任務訓練的 decoder-only LLM。Qwen 取最後位置的 yes/no token logits 差值;Mixedbread 依官方 LogitScore 設定取 1/0 token logits 差值。此評測直接使用分數排序,不逐字生成解釋,也不讓不同候選共享上下文。
雙向 LLM: Nemotron 文字版 以 Llama 3.2 1B 為底座,微調時改用雙向注意力,再將最後一層 token 表示做 mean pooling,交由二元分類頭評分;與保留因果注意力、讀取答案 token logits 的方法不同。
VLM: Nemotron VL 使用 Eagle 視覺語言架構,結合 SigLIP 2 視覺編碼器與 Nemotron 語言模型,透過 mean pooling 與二元分類頭評分,可處理文字與文件影像。本榜單僅使用純文字輸入,未評測影像能力。
Jina v3.5 的「微調 LLM (Listwise)」另標示為共同處理多份候選的排序方法。API 類型表示商業服務的提供方式,不由此推斷其內部模型架構。
Jev-batch-pointwise 排序方法
TypeSafe AI 的 Jev-batch-pointwise 評測 DRCD+TWSE 合併的全部 5,081 題。每題先以 OpenAI text-embedding-3-small 的 cosine similarity,從合併的 1,651 份文件選取前 100 份候選段落,再以固定 seed 42、題目 ID 與問題文字產生可重現的亂數排列,拆成 4 批、每批 25 份;文件過長時會進一步拆小批次,保留完整原文。
沿用 hev/reranker 的 generic-1 prompt:每份文件各問一個 Noul,判斷它是否包含回答或直接回應問題的資訊。Jev 回傳 0–1 的相關機率,將分數對回原始候選,合併全部 100 份後由高到低排序取前 5;同分保留第一階段順序,不使用機率門檻刪除候選。
底層模型固定為 jev-1.13.0;每題最多 4 個 calls、跨題最多同時處理 4 題,全域最多 16 個 HTTP 請求;每個 worker 重用連線,所有題目與重試共用每秒 80 次請求及估計 100,000 input tokens 的配額。超長文件拆成超過 4 批時,完成一批後再補下一批,實際發送須等待配額。每批文件共享同一份上下文,因此分數可能受批次組成影響,與一次只送一份文件的 pointwise 結果不保證相同。
Latency 為 5.781 秒/題(5,781.00 ms),採平均單題回應時間,包含組批、限流等待、API 請求、重試與排序,不含第一階段召回及存檔。Hit Rate@5 與 MRR@5 維持合併全量評測結果,第一階段未召回的題目仍計入分母。
Jev-pointwise 排序方法
TypeSafe AI 的 Jev-pointwise 使用固定 Jev jev-1.13.0 與相同 generic-1 Noul prompt。評測範圍是 DRCD+TWSE 合併的全部 5,081 題;每題先以既有 OpenAI text-embedding-3-small cosine similarity 選取 Top100,每次 API 只包含一題問題與一份文件全文,其他候選不進入上下文。全部 100 份文件各自取得 0–1 相關機率後合併排序取前 5,同分保留第一階段順序,不截斷文件或以門檻刪除候選。
題目循序處理,一題的全部候選完成評分後才處理下一題;題內最多 100 個 HTTP 請求並行,同時限制每秒 80 次請求及估計 100,000 input tokens,重試也計入相同配額。有足夠配額就繼續發送,不必等待前一個請求回應;每個 worker 重用 HTTP 連線。seed 42、題目 ID 與問題文字決定文件排程順序,實際送出次序可能因並行而不同。
每秒 80 次請求是目前本評測帳戶的 Jev API 官方預設 Rate limit,而非為測試額外設定的限速。因此,重排 100 份段落所需的 100 個請求無法一次全部發送,必須分散到超過一秒的時間內;與同樣採逐文件決策評分的 gpt-6-luna-decisions-pointwise 相比,Jev 在本次速度比較中承受配額上的劣勢,條件並非完全對等。Latency 同時反映 API 配額及排程,不能直接視為模型純推論速度的差距。實務上需要重排的候選數可能少於 80 份,這項 RPS 瓶頸的影響也可能較小;仍須考量文件長度、token 配額及同帳戶的其他流量。
Latency 為 2.601 秒/題(2,601.00 ms),採整批執行耗時換算平均,包含限流等待、API、重試、排序、題間配額恢復與結果存檔,不含第一階段召回。Hit Rate@5 與 MRR@5 維持合併全量評測結果,第一階段未召回的題目仍計入分母。
d1-3B-pointwise 排序方法
使用 LiquidAI 的 d1-3B ,部署來源為官方 d1-3B-GGUF ,透過既有 llama serve 的原生 decision 端點執行 Q8_0 權重。本次只載入文字模型,共2,697,198,592個參數,未掛載視覺編碼器;官方含視覺模組的完整模型為3.12B。沿用 Jev generic-1 Noul 相關性問題與正反判準,以回傳機率穩定排序,同分保留召回順序。只執行 DRCD+TWSE 合併全部5,081題/1,651份文件,每題由既有 OpenAI text-embedding-3-small 召回 Top100,逐文件獨立評分後取前5,未召回的題目仍計入分母。
題目循序執行,一題全部候選完成後才處理下一題;題內最多100個HTTP請求並行,每個worker重用連線,無額外RPS/TPS節流。官方原生context為32768 tokens,本次服務context為8192;此版服務要求完整prompt嚴格小於context,故保留一個位置,實際完整輸入上限8191 tokens,包含問題、文件、指令、選項與特殊tokens。使用服務tokenizer精確計數,優先保留問題並從文件尾端截斷,每份回應usage皆須與完整模板計數一致。
無額外暖機;Latency採全量5,081題的平均單題重排時間,包含tokenization、截斷、HTTP等待、推論、重試與Top5排序,不含第一階段召回及存檔。保存逐題全分數及HTTP收據,完成後獨立核對排序、指標、逐題請求區間與token上限;服務端推論並行量與硬體未另行假設,自架服務未提供供應商API牌價,也未估算硬體成本。
laya-multilingual-pointwise 排序方法
使用 Convai Innovations 的 Laya Multilingual ,底座為 mmBERT-base 加上 decision head,本次透過自架 llama.cpp 服務執行 Q8_0 權重,共 321,710,593 個參數。沿用 Jev generic-1 Noul 相關性問題與正反判準,以回傳的 0–1 相關機率排序,同分保留召回順序。只執行 DRCD+TWSE 合併全部 5,081 題/1,651 份文件;每題由既有 OpenAI text-embedding-3-small 召回 Top100,逐文件獨立評分後取前5,其他候選不進入上下文,未召回的題目仍計入分母。
題目循序執行,一題全部候選完成後才處理下一題;題內最多100個HTTP請求並行,每個worker重用連線,無額外RPS或TPS節流。使用服務本身的tokenizer計算包含問題、文件、判斷指令、選項與特殊tokens的完整輸入,最多8192 tokens;優先保留問題,從文件尾端截斷,並要求實際usage與完整prompt計數一致。服務端推論並行量與遠端硬體未另行假設,HTTP並行上限不代表100份文件同時在GPU執行。
無暖機;Latency為全部5,081題的平均單題重排時間,包含tokenization、截斷、HTTP等待、推論、重試與Top5排序,不含第一階段召回及存檔。保存全部候選分數與逐次HTTP收據,完成後獨立核對排序、指標、逐題區間及8192-token上限;自架服務未提供供應商API牌價,也未估算硬體成本。
gpt-6-luna-decisions-pointwise 排序方法
使用 OpenAI Decisions API 的 gpt-6-luna,沿用 Jev generic-1 的相關性問題與正反判準,以 predicate 回傳的 0–1 probability 排序。評測 DRCD+TWSE 合併全部 5,081 題;每題由既有 OpenAI text-embedding-3-small 召回 Top100,每次 API 僅包含問題與一份候選文件全文。全部100份評分後取前5,同分保留召回順序,不截斷文件或設定機率門檻;第一階段未召回的題目仍計入分母。
題目逐題執行,每題最多100個請求並行,共用100個HTTP連線,沒有額外RPS節流。停用SDK自動重試,暫時性錯誤最多另外重試3次;任何文件失敗或拒答都不產生部分排名。沒有暖機,Latency為1.127秒/題(1,127.00 ms),採平均單題回應時間,包含每題全部候選完成評分及排序、連線與重試,不含第一階段召回及存檔。客戶端並行量不代表伺服器內部並行量。Hit Rate@5與MRR@5維持合併全量結果;成本依本次保存的成功input tokens與官方牌價估算,非實際帳單。
gpt-6-luna-llmranker-listwise 排序方法
gpt-6-luna-llmranker-listwise 使用 OpenAI gpt-6-luna,透過 llmranker 的 Listwise 策略評測 DRCD+TWSE 合併的全部 5,081 題。每題先以 OpenAI text-embedding-3-small 的 cosine similarity,從合併的 1,651 份文件選取前 100 份候選,再交由 LLM 重排,取最終前 5 名計算指標。
Listwise 每次將問題與 20 份候選文件一起交給模型,要求輸出這 20 份文件的相關性排序。本次使用滑動視窗:從原始排名第 81–100 名開始,接著處理第 71–90 名,逐次向前移動 10 名,直到第 1–20 名,共執行一輪、每題 9 次 LLM 請求。相鄰視窗重疊 10 份文件,後一個視窗使用前一步更新後的順序,讓相關文件有機會逐步移向前段。
各視窗保留文件完整原文,模型設定 temperature=0、reasoning_effort=none。題目逐題執行,單題 max_concurrency 設為 100,但因視窗之間相互依賴,這 9 次請求仍依序執行,實際題內並行為1。最終分數依排序位置遞減,並非每份文件的相關機率。Latency 為18.071秒/題(18,071.00 ms),採平均單題回應時間,包含全部視窗的 API 請求、重試與排序,不含第一階段檢索及存檔。Hit Rate@5與MRR@5維持合併全量結果;第一階段未召回的題目仍計入評測分母。
gpt-6-luna-llmranker-pointwise 排序方法
gpt-6-luna-llmranker-pointwise 使用 OpenAI gpt-6-luna,透過 llmranker 的 Pointwise 策略評測 DRCD+TWSE 合併的全部 5,081 題。每題先以 OpenAI text-embedding-3-small 的 cosine similarity,從合併的 1,651 份文件選取前 100 份候選,再交由 LLM 逐份評分,取最終前 5 名計算指標。
每次 LLM 請求只包含問題與一份候選文件,保留完整原文,要求模型給出 0–10 的相關性分數。每題的 100 份文件各自完成評分後,將全部分數由高到低排序,同分保留第一階段的召回順序。分數是模型給出的相關性評分,並非校準過的機率;每題需 100 次 LLM 請求,不含重試。
模型設定 temperature=0、reasoning_effort=none。題目逐題執行,題內 max_concurrency=100,使用100個持續存在的請求worker,沒有額外400 RPS節流。Latency 為9.262秒/題(9,262.00 ms),採平均單題回應時間,包含全部100份候選的 API 請求、重試及排序,不含第一階段檢索及存檔。Hit Rate@5與MRR@5維持合併全量結果;第一階段未召回的題目仍計入評測分母。
評測方法
這份榜單評估 Embeddings 與 Reranker 模型在繁體中文檢索任務中,能否找回問題對應的正確段落。兩種模型分別排名,測試聚焦 RAG 的檢索環節,不包含 LLM 回答生成。
01 資料集與標準答案
本頁將 DRCD 與 TWSE-news-v1 合併為同一個檢索評測:DRCD 的 1,000 份段落、3,493 題 ,加上 TWSE-news-v1 的 651 份文件、1,588 題 ,共 1,651 份文件、5,081 題 。每一題都搜尋全部 1,651 份文件,再對全部 5,081 題取平均;不按資料集分開檢索或計分。
DRCD 使用 MediaTek-Research/TCEval-v2 的 drcd test split,將繁體中文閱讀理解題目轉成找回來源段落的檢索任務。
表格另列兩份資料集的獨立 Hit Rate@5 與 MRR@5:DRCD 的 3,493 題搜尋其 1,000 份段落,TWSE-news-v1 的 1,588 題搜尋其 651 份文件。「全部資料」兩項指標則讓每題搜尋全部 1,651 份文件,沿用合併評測結果;它不是兩份獨立分數的平均。
TWSE-news-v1 取自 臺灣證券交易所新聞清單 於 2026/10/13 保存的固定快照,涵蓋民國 115/01/02–115/10/12 的 651 則新聞 PDF。使用 LiteParse 解析,必要頁面補做繁體中文 OCR。每份 PDF 的完整 Markdown 為一份文件,保留標題、正文及表格,不再切成多個段落。
每份文件由獨立 gpt-6-luna 子代理合成 1–3 題,再逐份核對來源、引用與推導,共 1,588 題:明確事實 651 題、隱含事實 577 題、可解釋推理 360 題。
02 Embeddings:以向量檢索前五名
Embedding 模型分別將問題與段落編碼成向量,這種方式常稱為 Bi-Encoder。文件向量可預先建立索引,再以問題向量比對相似度;本榜單直接使用已保存的問題與段落向量評測。
同一模型分別將全部候選段落與問題轉成向量,依各模型的官方檢索設定使用文件/問題前綴或 task type。
每個問題與全部候選段落逐一計算 cosine similarity(餘弦相似度),依相似度由高到低取前 5 名。
檢查標準答案是否出現在前 5 名,以及所在名次,計算單題得分後對全部問題取平均。
使用完整候選集的精確搜尋,不使用向量資料庫的近似最近鄰(ANN)索引,因此分數不包含 ANN 搜尋造成的召回損失。每個模型都在自己的向量空間中搜尋,不混用不同模型的向量。
BM25 詞彙檢索 Baseline :Embedding 榜另列 rank-bm25 的 BM25Okapi(k1=1.5、b=0.75、epsilon=0.25),以 dict.txt.big 與 jieba.cut_for_search(HMM=True)對文件和問題分詞,保留全部 token。使用相同全文與標準答案,依 BM25 分數取前 5 名;同分保留文件索引順序。DRCD、TWSE 各自建索引,合併評測則用完整合併文件庫重新計算 IDF 與平均文件長度。
03 Reranker:兩階段檢索與重排
Reranker 評測使用 DRCD 與 TWSE-news-v1 合併的 1,651 份文件與全部 5,081 題,每題在同一個完整文件庫召回 Top 100。表格呈現全部資料的 Hit Rate@5 與 MRR@5。
常見的 Reranker 使用 Cross-Encoder,將問題與一份候選文件一起輸入,直接取得相關性分數。本輪 BGE、MiniLM 與 GTE multilingual reranker 使用原始 logits,Qwen 依官方 yes/no logits 差值排序,Mixedbread 依官方 chat template 與 1/0 logits 差值排序;Cohere 與 Voyage 使用供應商回傳的 relevance score,再映射回原始候選文件。分數越高代表越相關,不同模型的相關性分數不直接互相比較。
表格中的 Baseline 直接取 OpenAI text-embedding-3-small 向量檢索的前 5 名,並另列 BM25 全文檢索的同一組 Top 5 分數作為比較基準;兩者皆不執行重排。BM25 的數值沿用 Embedding 榜,Reranker 的候選來源仍固定為 OpenAI text-embedding-3-small。
圖片出處:Boosting Your Search and RAG with Voyage’s Rerankers
第一階段選候選 :固定使用 OpenAI text-embedding-3-small 的既有索引,對每個問題與全部段落計算 cosine similarity,選取 Top-k 100 筆;段落不足 100 筆時使用全部段落。第二階段重排 :依模型官方流程,對全部 100 份候選計算相關性分數,依分數由高到低重排取前 5 名。保持原始文件粒度,不將正確文件額外插入候選。依最終名次計分 :用重排後的前 5 名計算 Hit Rate@5 與 MRR@5,再對全部問題取平均。同分時保留前一階段的排序。
Reranker 只能重排已選入的候選段落。若第一階段未召回正確段落,該題兩項指標都計 0,仍包含在平均值的分母中;因此第一階段的 Recall@100 是最終 Hit Rate@5 的上限。
實際輸入長度與模型最大規格分開記錄:MiniLM/BGE 本輪沿用 512 tokens,Qwen、Mixedbread 與 GTE multilingual reranker 使用 8,192 tokens。Cohere 設定 max_tokens_per_doc=32,768,Query 與文件共用模型 context;Voyage 使用 32,000 tokens 上限及官方自動截斷。超長文件可能截斷,但檢索文件與標準答案映射仍保持完整來源。
本機模型逐一在 RTX 5070 Ti 執行;API 的候選提交方式、題內與跨題並行依各模型設定,詳見各排序方法。Latency 包含 tokenization、推論、排序或 API 往返/重試,排除第一階段搜尋與暖機;Jev-pointwise 另採整批平均耗時,包含題間配額恢復及存檔。每完成一個模型後驗證全量結果並更新網站。
04 Hit Rate@5 與 MRR@5 如何計分
Embeddings 分頁使用向量檢索或 BM25 詞彙檢索的前 5 名;Reranker 分頁使用重排後的前 5 名。兩者採用相同的標準答案與以下計分方式。
Hit Rate@5 :正確段落在前 5 名內得 1 分,否則得 0 分。榜單顯示全部問題的平均值,以百分比表示;越高代表越多問題能找回正確段落。
MRR@5(平均倒數排名) :正確段落在第 r 名時得 1 / r 分;未進入前 5 名得 0 分。榜單顯示全部問題的平均值,範圍為 0–1;越高代表正確段落更常出現在靠前的位置。
05 Embedding 與 Reranker 延遲如何量測
開源模型在 NVIDIA RTX 5070 Ti 顯示卡 上執行;API 模型的延遲是呼叫遠端服務的耗時,包含網路往返。
Embedding :batch size = 1,記錄每筆問題或段落產生向量的耗時,取平均,單位為毫秒/筆。
BM25 :在 CPU 逐題量測問題分詞、文件評分與 Top 5 排序,全部問題的耗時總和除以題數,顯示於 Latency 欄(毫秒/題)。排除字典載入、建索引與存檔;不納入向量模型的效能與成本散點圖。
Reranker :記錄每題重排 100 筆候選段落的耗時,取平均,單位為毫秒/題。
一般不含模型載入與結果寫入時間;Jev-pointwise 採整批平均耗時,另包含題間配額恢復與結果存檔,詳見其排序方法。數值會受硬體、精度、文字長度與網路狀況影響,僅供相對比較。
合併評測沿用兩份來源索引的逐筆 Embedding 耗時,對全部文件及問題取算術平均;DRCD 與 TWSE-news-v1 可於不同時間建立索引,因此延遲不是同一輪量測,亦可能包含長文件記憶體優化前後的不同執行條件。
06 如何解讀這份榜單
測試直接使用既有段落,不評估文件切塊、OCR、混合搜尋或完整 RAG 的答案品質,也未測分類與分群能力。
選型時可同時考量命中率、排名品質、延遲、維度、輸入上限、價格與授權,再用實際應用的文件及問題重跑評測。