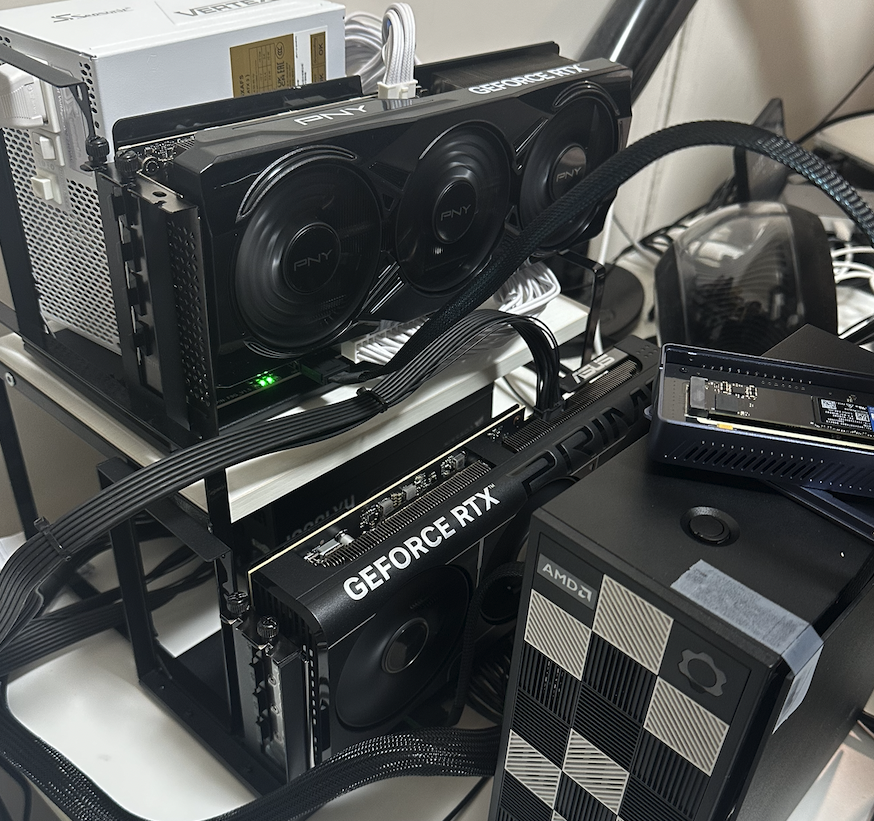
在 Framework Desktop 擴充 NVIDIA GPU:用 OCuLink 外接 RTX 5070 Ti 之後,發現 Nvidia 顯卡的新天地。
相比跑 LLM,我認為跑 Embedding、Reranker、Decision Model 在地端用來開發 AI 應用大有可為,用 5070Ti、5080 消費級高階顯示卡來跑就足夠快(甚至比呼叫雲端 API 還快了),已經能滿足 production 應用的需求。而且雖然顯卡 ram 不多,但因為這類模型夠小,一張卡就放得下,因此可以很容易就透過多張卡平行跑來提高吞吐量跟速度。
例如,RAG 匯入新文件時,需要一次產生大量 Embeddings,就可以把資料分給兩張卡,各自計算。Reranker 一次要重排 100 筆文件,也可以拆成兩批平行處理,最後再合併分數排序即可。Decision Model 每筆判斷彼此獨立,也能用同樣的方式分工。
雖然單卡就夠快了,但多一張卡能直接增加整體吞吐量速度,於是趕緊再添購一張 RTX 5080 (這也越來越難買了,都要主機板組合但我又沒有要組新電腦,我買到 pchome 上最後一張是組合電源供應器的),就可以讓 Embedding、Reranker、Decision Model 的速度超越雲端模型,畢竟雲端 API 還有網路往返耗時呢。
那推薦用哪些開源模型呢? 我正在重新評測做新的排行榜。
Framework Desktop 的硬體擴充
上回提到,Framework Desktop 機殼內的 PCIe x4 插槽空間很小,不太好擴充。後來我找到一張內接型的 OCuLink 轉接卡,它的 OCuLink 接頭朝向機殼內部,不需要機殼背面對外開孔,剛好解決了安裝空間的問題,順利從這個插槽接出第二張顯卡。
那原本裝在 PCIe 轉接卡上的第二個 M.2 SSD 怎麼辦? 只好再搬一次家,這次改用外接 SSD 盒,透過 USB-C 連接。好在 Framework Desktop 背面的 USB-C 連接埠支援 USB4,速度有到 40Gb,於是我買了這台 ACASIS 阿卡西斯 TBU405 40Gbps 外接盒,把 PCIe 插槽讓給第二張顯卡。
硬體搞定後,軟體就不難了。兩張卡各自跑一份相同的模型服務在不同 port,前面再放一個用 Vibe coding 刻的 Rust 超快 gateway 分流請求即可。
後記 (2026/10/27):
跑了幾天發現訊號不穩,除了開機顯卡就會有 RxErr+ 錯誤,雖然還能運作,但不定時會莫名整張卡掛掉不能用。
後來找到一個 workaround 是進到 BIOS 把這個 PCI-e 降速到 Gen 3。目前開機不會有 RxErr+ 警告,貌似正常了。這台 Framework Desktop 的內建 PCI-e 插槽位置真的太糟糕了,位在一個空間超窄散熱超級差的地方 :(